3.3 差错控制
对应王道教材 3.3 节(教材 P56–P58)· 本节属于 408 考纲范围
实际的通信链路并非理想,比特在传输过程中可能产生差错:1 可能变为 0,0 也可能变为 1,这种现象称为比特差错。比特差错是传输差错的一种,本节仅讨论此类差错。
通常采用编码技术进行差错控制,主要分为两类:检错编码和纠错编码。采用检错编码时,接收方若检测到差错,会设法通知发送方重传,直到收到正确的数据为止;采用纠错编码时,接收方不仅能发现差错,还能确定错误位置并加以纠正。
码距:衡量检错与纠错能力的参数 考点
码距(也称海明距离)是指两个码字在对应位上取值不同的比特数量。计算码距的一种方法是对两个位串进行异或(xor)运算,结果中 1 的个数即为码距。例如 \(0110\oplus 0011=0101\),结果中有两个 1,说明这两个码字有 2 位不同,因此其码距为 2。
在一个编码集中,任意两个有效码字之间码距的最小值称为该编码集的码距。例如,对于编码集 {10011, 01011, 11110, 00001}:虽然 11110 与 00001 的码距为 5,但 10011 与 01011 的码距仅为 2,取各码距中的最小值,求得该编码集的码距为 2。
根据差错控制理论,编码方案的检错能力和纠错能力与码距 \(l\) 的关系如下:
即码距 \(l\) 越大,其检错的位数 \(d\) 就越大,纠错的位数 \(c\) 也越大,且纠错能力恒不超过检错能力(能纠错必然能检错)。例如,当码距 \(l=3\) 时,该编码最多可检测 2 位错误,或纠正 1 位错误。进一步考虑 \(c=0\) 或 \(d=c\) 的两种边界情况,还可得出以下两个重要结论:
- 为检测 \(d\) 位错误,编码方案的码距至少应为 \(d+1\)。任何发生 \(d\) 位错误的有效码字不可能变成另一个有效码字,以确保差错可被发现。例如,码距为 1 的编码无法检测任何错误。
- 为纠正 \(c\) 位错误,编码方案的码距至少应为 \(2c+1\)。即使一个有效码字发生 \(c\) 位错误,其仍然离原始码字最近,接收方可据此唯一确定原始码字,实现纠错。
3.3.1 检错编码 考点
检错编码均采用冗余编码技术,其核心思想是:在有效数据(信息位)发送前,按照特定规则附加若干冗余位(检验位),构成一个符合预设编码规则的码字后再发送。当信息位发生变化时,冗余位也会相应调整,以确保整个码字始终满足该编码规则。接收方通过校验收到的码字是否仍符合这一规则,来判断是否发生了差错。若某些比特在传输中出错,则可能违反原有的编码规则,进而使差错被有效检测出来。常见的检错编码包括奇偶检验码和循环冗余码。
1.奇偶检验码
奇偶检验码是奇检验码和偶检验码的统称,是最基本的检错码。它由 \(n\) 位数据和 1 位检验位组成,检验位的取值(0 或 1)使得整个码字中"1"的个数为奇数(奇检验)或偶数(偶检验):
- 奇检验码:附加检验位后,码字中"1"的总数为奇数。
- 偶检验码:附加检验位后,码字中"1"的总数为偶数。
7 位数据 1001101 中有 4 个"1"(偶数个),因此:
- 对应的奇检验码为
10011011——加 1,使"1"的总数变为 5 个(奇数); - 对应的偶检验码为
10011010——加 0,使"1"的总数保持 4 个(偶数)。
奇偶检验码只能检测奇数位错误,无法发现偶数位错误,也无法定位错误位置。由于任意两个合法码字之间至少有 2 位不同,其码距为 2;根据码距理论,此类编码最多可检测 1 位错误。而实际上,只要发生奇数位错误,"1"的总数奇偶性必然改变,因此能检测所有奇数位错误。
2.循环冗余码
循环冗余码(Cyclic Redundancy Code,CRC)是数据链路层广泛采用的一种高效检错技术,具有检错能力强、实现简单、硬件支持成熟等显著优势,其基本原理如下。
CRC 的核心思想:将待发送的数据视为一个二进制多项式,通过与一个预定义的生成多项式 \(G(x)\) 进行特定运算,生成一段冗余校验信息(称为检验序列,FCS),并将其附加在原始数据之后。接收方则使用相同的 \(G(x)\) 对整个接收到的帧进行验证,从而判断传输过程中是否出现差错。CRC 校验过程的具体描述如下。
- 约定生成多项式 \(G(x)\):收发双方事先约定一个 \(r+1\) 阶的生成多项式 \(G(x)\),其对应的二进制系数串长度为 \(r+1\) 位,且最高位和最低位必须为 1。例如,位串 1101 对应多项式 \(x^3+x^2+1\),其阶数 \(r=3\)。
- 发送方生成 FCS:假设待发送数据为 \(m\) 位,记作位串 \(M\);在 \(M\) 后面添加 \(r\) 个 0,得到长度为 \(m+r\) 的扩展串(相当于将 \(M\) 左移 \(r\) 位,即乘以 \(2^r\));用 \(G(x)\) 对应的位串对该扩展串进行模 2 除法(不进位的二进制除法,其减法操作由异或实现);所得余数(共 \(r\) 位,不足时补前导 0)即为 FCS;将原扩展串末尾的 \(r\) 个 0 替换为 FCS,形成最终发送帧(\(2^r M + \text{FCS}\)),总长度为 \(m+r\) 位。
- 接收方校验:接收方收到整个帧(可能出错)后,用相同的 \(G(x)\) 对其进行模 2 除法:若余数为 0,则认为传输无差错,接受该帧;若余数非 0,则认为存在差错,丢弃该帧。
以数据 \(M=101001\)(\(m=6\))、生成多项式 \(G(x)=1101\)(对应 \(r=3\))为例,CRC 校验码的计算步骤如下:
- 左移补零:在 \(M\) 后加 3 个 0,即
101001000。 - 模 2 除法:用 1101 去除 101001000(见图 3.8)。模 2 除法规则:减法不借位,等价于按位异或;从最高位开始,每次对齐除数进行异或,直到处理完所有位:
10100首位商 1,异或1101→0110 1...;- 落下后续位继续:商为 1 时异或 1101,商为 0 时直接落下;
- 逐步进行,最终余数为
001。
- 取余数:最终余数为
001(必须保留为 3 位,不足补前导 0)。 - 构造发送帧:将余数作为 FCS 附加到原始数据后,即
101001001(共 9 位)。
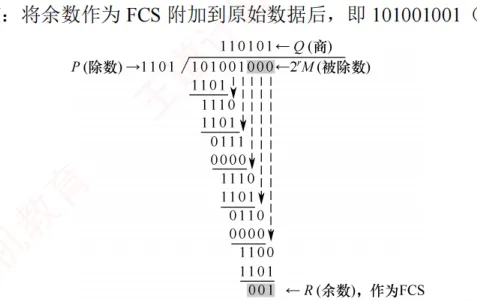
普通除法要比较大小、借位退位,而模 2 除法只看当前首位:首位是 1 就商 1、拿除数异或下来;首位是 0 就商 0、直接落下。这是因为"不借位的减法"与异或在数学上完全等价(相同为 0、不同为 1)。于是硬件上用一排异或门、一拍一位就能"除"完整个位串——这正是 CRC"实现简单、硬件支持成熟"的根源。
CRC 的生成与检验通常由专用硬件电路实现,速度极快,几乎不会引入额外的延迟。若传输过程中无差错,则 CRC 检验所得余数必定为 0;若出现误码,余数仍为 0 的概率极低。因此,在工程实践中通常认为"凡是被数据链路层接受的帧,几乎可以确定在传输过程中未发生差错"。而那些被丢弃的帧,尽管物理上曾被收到,却因 CRC 校验失败而未被上层接受。
3.3.2 纠错编码 考点
最常见的纠错编码是海明码。其基本原理是:在原始信息位中插入若干检验位,构成具有检错与纠错能力的海明码。每个检验位对应一个校验组(通常采用偶检验),用于校验海明码中的若干信息位。通过将每个信息位分配到多个检验组中,当某一位出错时,会引发其所属的多个检验组同时出现校验错误,从而不仅能检测出错误,还能确定错误位置,实现单比特纠错。
(1)确定海明码的总位数。设信息位有 \(n\) 位,检验位有 \(k\) 位。\(k\) 个检验位可表示 \(2^k\) 种状态:信息位和检验位共有 \(n+k\) 种单比特出错的位置,此外还需 1 种表示无错状态。因此 \(n\) 与 \(k\) 需满足:
本例中 \(n=4\),尝试 \(k=3\):\(2^3=8\geqslant 4+3+1=8\) 成立。故取 \(k=3\),海明码共 \(n+k=7\) 位。记信息位为 \(D_4D_3D_2D_1=1010\),检验位为 \(P_3P_2P_1\),海明码位号从右至左依次为 \(H_7H_6H_5H_4H_3H_2H_1\)。
(2)确定检验位的分布。规定:检验位 \(P_i\) 放在海明位号为 \(2^{i-1}\) 的位置上,其余各位放置信息位。因此:
- \(P_1\) 的海明码位号为 \(2^0=1\),即 \(H_1\) 为 \(P_1\);
- \(P_2\) 的海明码位号为 \(2^1=2\),即 \(H_2\) 为 \(P_2\);
- \(P_3\) 的海明码位号为 \(2^2=4\),即 \(H_4\) 为 \(P_3\)。
将信息位按原顺序放在剩余位置,得到海明码的分布:
| 位号 | \(H_7\) | \(H_6\) | \(H_5\) | \(H_4\) | \(H_3\) | \(H_2\) | \(H_1\) |
|---|---|---|---|---|---|---|---|
| 内容 | \(D_4\) | \(D_3\) | \(D_2\) | \(P_3\) | \(D_1\) | \(P_2\) | \(P_1\) |
(3)分组以形成检验关系。每个信息位由多个检验位共同校验,需满足条件:信息位所在位号 = 其所参与的所有检验位位号之和(检验位不需要再被检验)。分组形成的检验关系如下:
- \(D_1\) 位于 \(H_3\),由 \(H_1H_2(P_1P_2)\) 检验(因为 \(3(011)=1+2\));
- \(D_2\) 位于 \(H_5\),由 \(H_1H_4(P_1P_3)\) 检验(因为 \(5(101)=1+4\));
- \(D_3\) 位于 \(H_6\),由 \(H_2H_4(P_2P_3)\) 检验(因为 \(6(110)=2+4\));
- \(D_4\) 位于 \(H_7\),由 \(H_1H_2H_4(P_1P_2P_3)\) 检验(因为 \(7(111)=1+2+4\))。
(4)检验位取值。检验位 \(P_i\) 的值为其对应校验组中所有位(含信息位)求异或(偶校验结果)。根据(3)中的分组(代入 \(D_4D_3D_2D_1=1010\),即 \(D_4=1,D_3=0,D_2=1,D_1=0\)):
因此,1010 对应的海明码为 1010010(即 \(H_7{\sim}H_1\) = 1,0,1,0,0,1,0,下划线/粗体位为检验位,其余为信息位)。
(5)海明码的检验原理。每个检验组分别利用检验位和参与形成该检验位的信息位进行奇偶检验检查,构成 \(k\) 个检验方程:
若 \(S_3S_2S_1\) 的值为"000",表示无错误;否则表示出错,且这个数就是错误位的位号。如 \(S_3S_2S_1=001\),表示第 1 位出错,即 \(H_1\) 出错,直接将其取反即可达到纠错的目的。
通过少量冗余检验位,即可实现单比特错误的自动定位与纠正。所需检验位数 \(k\) 由 \(2^k \geqslant n+k+1\) 确定——例如 \(n=10\) 时 \(k=4\)(\(2^4=16\geqslant 15\)),\(n=11\) 时 \(k=4\) 依然够用,\(n=12\) 则需 \(k=5\)。